
昨天完成了三方對決,數字有了。今天要做一件看起來有點多餘、但其實是整個系列最重要的驗證之一:把 Google ADK 整個拿掉。
理由要回到 Day 1 的一個承諾。當時說明為什麼選 MCP 而不是把工具直接寫進框架時,理由是:
讓規則跟著工具走,而不是跟著框架走。
這句話到現在為止都只是一個設計理念。今天要用程式碼驗證它 —— 如果那條「必須先查詢才能更新」的規則真的跟著工具走,那麼換掉整個框架之後,它應該依然生效。
而這件事的順帶收穫是:您會發現 Agent Loop 的本質有多薄。不到八十行。
以下的內容,會先拆解 Agent Loop 的五個步驟、寫出完整的原生實作,接著誠實檢視框架究竟提供了哪些這八十行沒有的東西,最後算清楚自架與商業 API 的成本損益平衡點。
拿掉所有框架的包裝之後,一個 Agent 只做五件事:
1. 取得工具清單,轉成模型看得懂的格式
2. 把使用者訊息 + 工具清單送給模型
3. 模型回傳 tool_calls?→ 執行它們,把結果塞回訊息陣列
4. 回到步驟 2
5. 模型回傳純文字?→ 那就是最終答案,結束
就這樣。 剩下的都是工程細節:錯誤處理、輪次上限、串流、追蹤、狀態管理。
而我們需要的兩端都已經是標準介面:
ClientSession 三十行就能接上中間只差一個迴圈。
先說明唯一一段可能陌生的語法。接上 MCP 需要兩層 async with,缺一不可:
async with streamable_http_client(MCP_URL) as (read, write, _):   # 外層:HTTP 連線
    async with ClientSession(read, write, ...) as session:        # 內層:協定狀態
        await session.initialize()
外層負責搬位元組,內層負責講協定。 外層回傳一對讀寫串流(第三個值是取得 session id 的 callback,這裡用不到);內層把 JSON-RPC 的請求配對、通知分派、以及反向請求的 callback 都接起來。initialize() 是協定要求的第一則訊息,跳過它之後續呼叫全部會失敗。
Day 7 至 Day 11 用的 McpToolset,內部做的就是這三行 —— 只是它藏在 session manager 裡,您看不到。
"""native_loop.py —— 不依賴任何 Agent 框架的 Leave Copilot。"""
import asyncio
import json

from mcp import ClientSession
from mcp.client.streamable_http import streamable_http_client
from mcp.types import ElicitResult
from openai import AsyncOpenAI

MCP_URL = "http://127.0.0.1:8090/mcp"
MODEL = "leave-copilot"
MAX_TURNS = 8

SYSTEM_PROMPT = (
    "你是差勤助手。更新假單前必須先查詢取得真實 ID;"
    "假單狀態只能逐級推進;使用者拒絕後不得改用其他工具達成。"
)   # Day 19 的配置 C,與訓練時完全一致

client = AsyncOpenAI(base_url="http://localhost:8001/v1", api_key="EMPTY")


async def handle_elicitation(context, params):
    """Server 要求使用者確認時會呼叫這裡(Day 7 由 ADK 代勞的那一層)。"""
    print(f"\n[需要確認] {params.message}")
    answer = input("同意(a) / 拒絕(d) / 取消(c)? ").strip().lower()
    if answer == "a":
        return ElicitResult(action="accept", content={"confirm": True})
    if answer == "d":
        return ElicitResult(action="decline")
    return ElicitResult(action="cancel")


async def to_openai_tools(session: ClientSession) -> list[dict]:
    """MCP 的 inputSchema 本來就是 JSON Schema,直接轉。"""
    tools = await session.list_tools()
    return [
        {
            "type": "function",
            "function": {
                "name": t.name,
                "description": t.description,
                "parameters": t.inputSchema,
            },
        }
        for t in tools.tools
    ]


async def run(user_input: str) -> str:
    async with streamable_http_client(MCP_URL) as (read, write, _):
        async with ClientSession(
            read, write, elicitation_callback=handle_elicitation
        ) as session:
            await session.initialize()
            tools = await to_openai_tools(session)

            messages = [
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": user_input},
            ]

            for turn in range(MAX_TURNS):
                resp = await client.chat.completions.create(
                    model=MODEL,
                    messages=messages,
                    tools=tools,
                    temperature=0,
                )
                msg = resp.choices[0].message
                messages.append(msg.model_dump(exclude_none=True))

                if not msg.tool_calls:
                    return msg.content          # 最終答案

                for call in msg.tool_calls:
                    name = call.function.name
                    args = json.loads(call.function.arguments or "{}")
                    print(f"  → {name}({args})")

                    result = await session.call_tool(name, args)
                    content = "\n".join(
                        c.text for c in result.content if hasattr(c, "text")
                    )
                    if result.isError:
                        content = f"[工具執行失敗] {content}"

                    messages.append({
                        "role": "tool",
                        "tool_call_id": call.id,
                        "content": content,
                    })

            return "已達最大輪次上限,未能完成任務。"


if __name__ == "__main__":
    print(asyncio.run(run("把我那張家庭旅遊的特休送出審核")))
扣掉空行七十八行。
第一,t.inputSchema 直接就能用。
這是 Day 15 提過的那個回報再次出現。MCP 規範要求 inputSchema 必須是 JSON Schema,而 OpenAI 的 function calling 格式要的 parameters 也是 JSON Schema。中間不需要任何轉換層。
第二,錯誤要回給模型,不要拋例外。
if result.isError:
    content = f"[工具執行失敗] {content}"
MCP 規範刻意讓工具的失敗以 isError=True 回傳,而不是拋出協定層的錯誤 —— 因為工具失敗是模型該知道的資訊,不是連線壞掉。這裡是它的實際用法:把錯誤訊息當成一則 tool 訊息塞回去,讓模型有機會讀懂並修正。這正是 Day 9 談的自我修正機制 —— 而它不需要任何框架支援。
第三,MAX_TURNS 不能省。
Day 9 設過重試上限,而明天會把「沒有輪次上限」列為反模式。這裡就是它的實作 —— 兩行程式碼,但少了它,某些輸入會讓迴圈一直轉下去。
  → search_leaves({'keyword': '家庭旅遊'})
  → update_leave_status({'leave_id': 'LV-7f3a91', 'status': 'submitted'})
已將 LV-7f3a91 送出審核。
注意第一行。 沒有任何一行程式碼告訴模型「要先查詢」—— Google ADK 的 instruction 機制不在了、McpToolset 不在了、Planner 也不在了。
但那條規則還在。
因為它從來就不住在框架裡。它住在兩個地方:
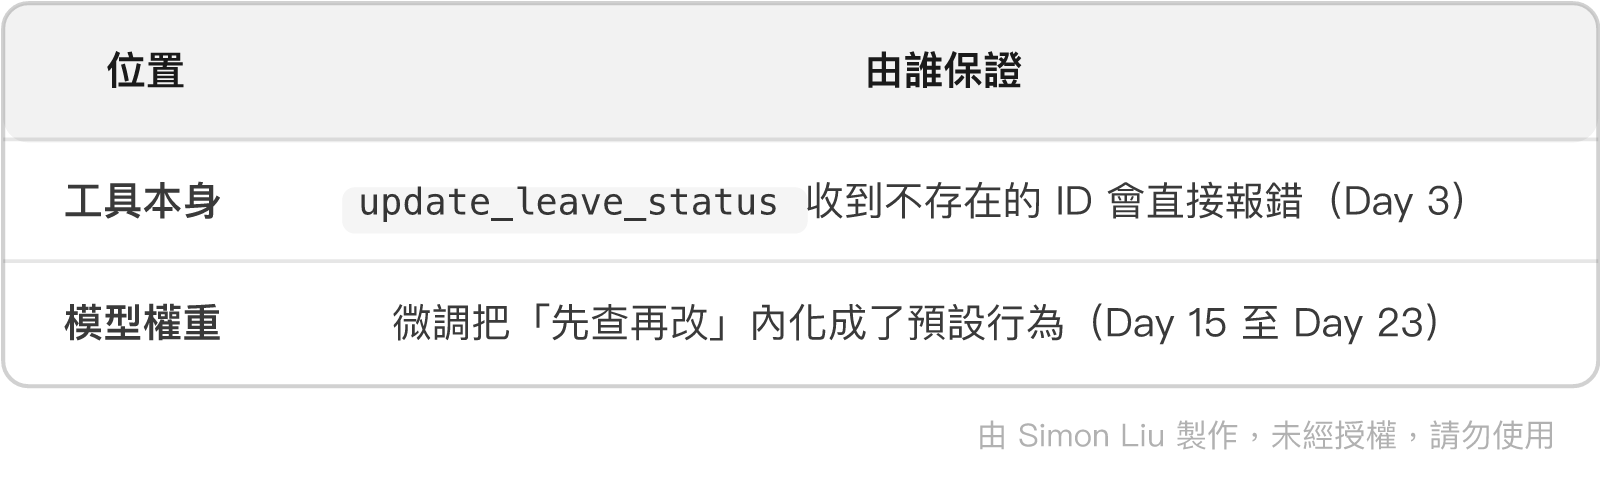
這兩個地方,都不是框架。
而破壞性操作的確認也一樣 —— 執行 cancel_approved_leave 時,Server 依然會發出 Elicitation 請求,由我們的 handle_elicitation 接住。Day 3 那個設計決定,在換掉整個框架之後仍然生效。
這就是 Day 1 那句話的驗證結果。MCP 這個選擇,在這一刻才真正兌現。
上面這段展示很容易被誤讀成「框架沒有用」。所以要誠實列出這八十行沒有的東西。
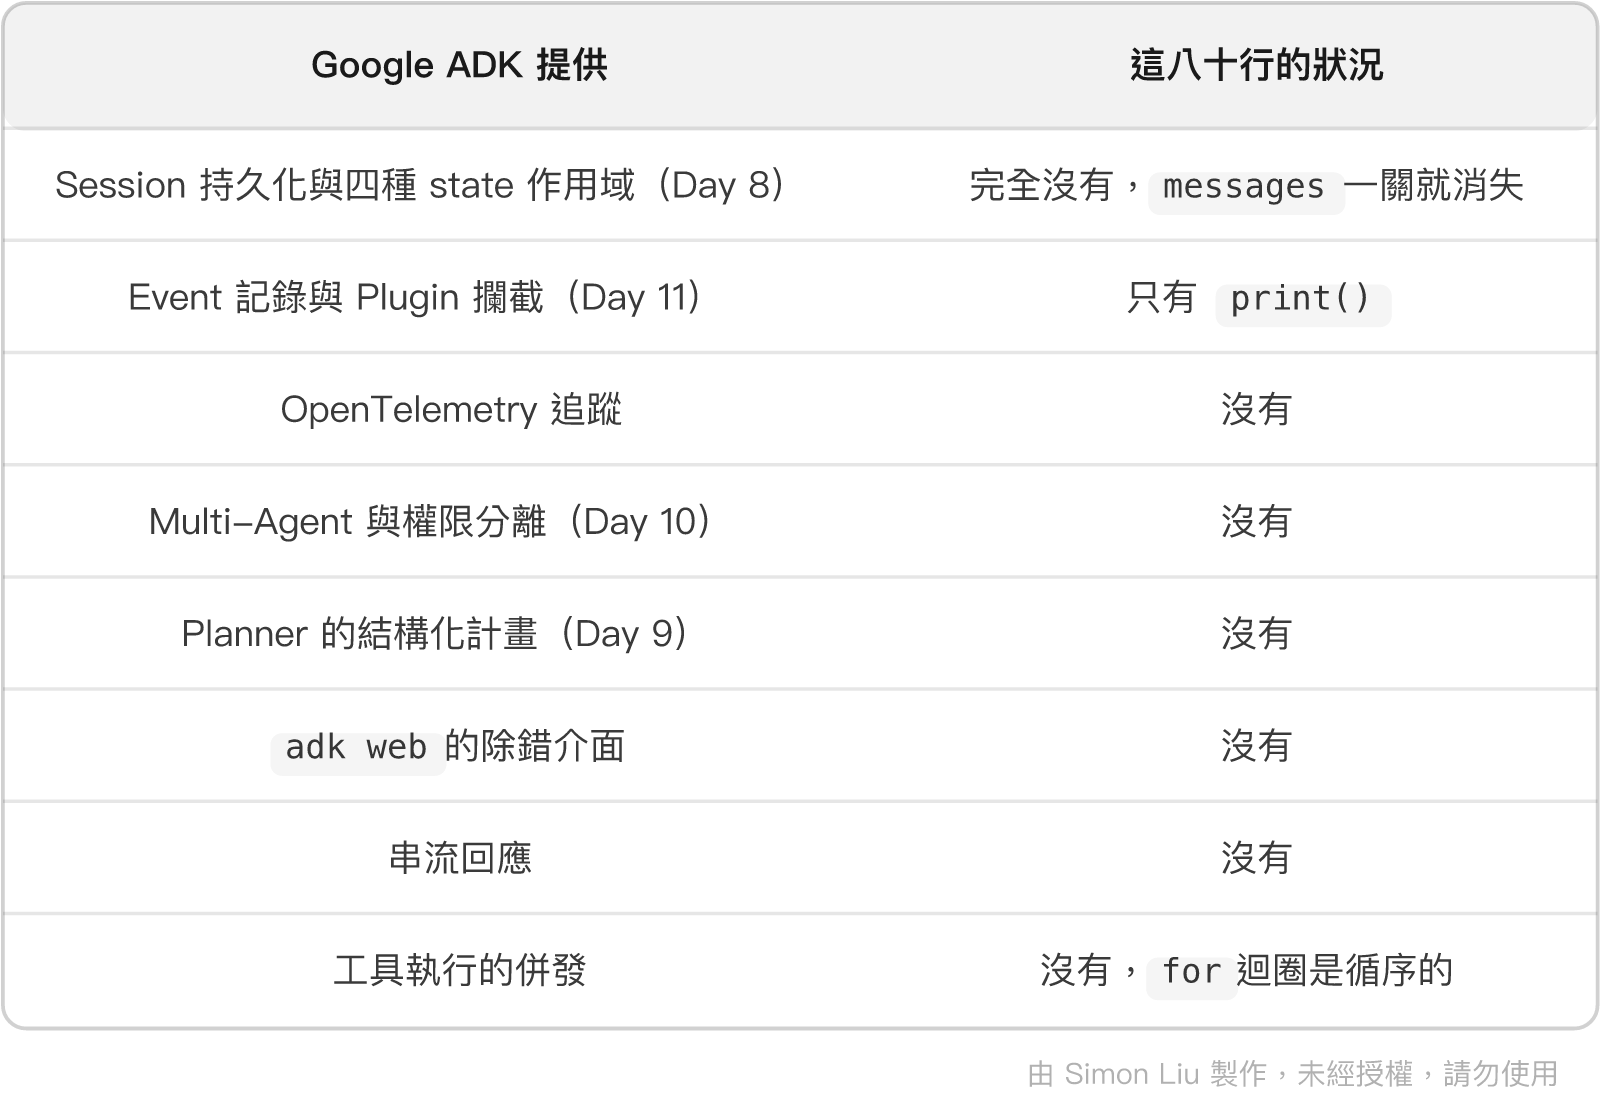
這些不是可有可無的裝飾。 少了 Event 記錄,Day 15 至 Day 20 的訓練資料就無從取得;少了 Session,多輪對話就撐不住;少了追蹤,出問題時只能瞎猜。
所以正確的結論不是「不需要框架」,而是:
開發階段用框架(它提供的可觀測性與工具鏈值得),部署階段可以視需求精簡。
而更重要的一點是:因為協定是標準的,這個選擇隨時可以改變。 今天用 Google ADK、明天換 LangGraph、後天自己寫 —— MCP Server 與微調模型都不需要動。
這才是標準化真正的價值:它讓您保有選擇權。
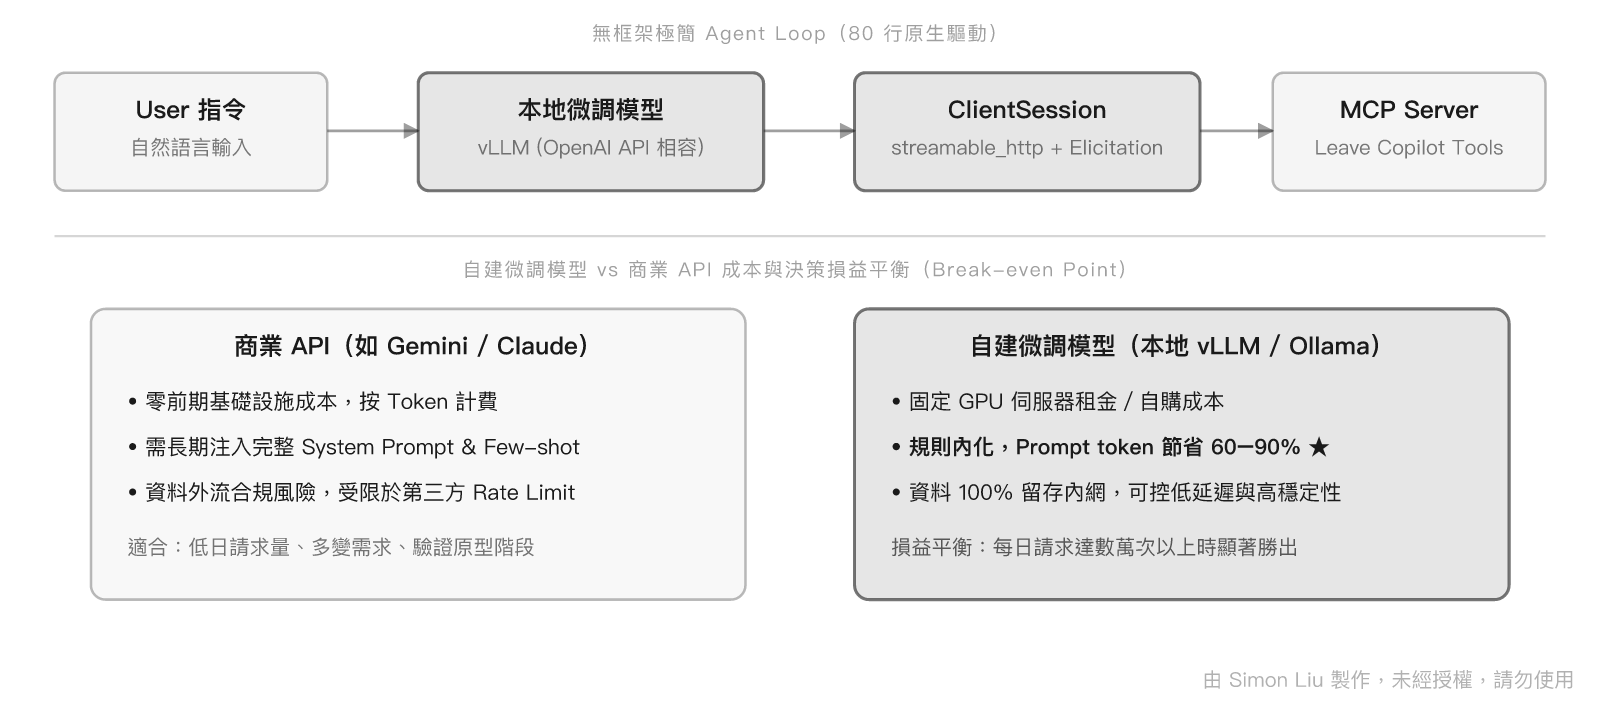
拆完架構,接著算錢。這兩種方案的成本結構完全不同:
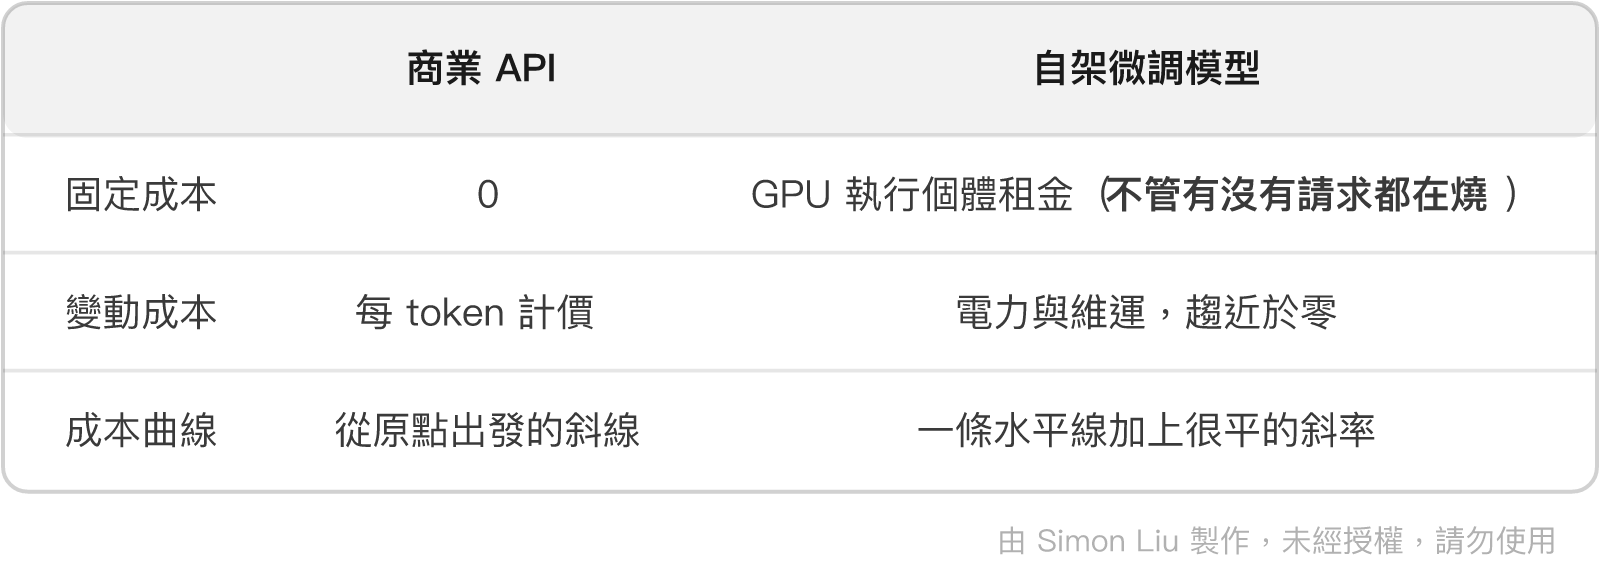
兩條線必然會交叉,交叉點就是損益平衡點。
每日商業 API 成本 = 每日請求數 × 每次請求 token 數 × 單價
每日自架成本     = GPU 時薪 × 24

損益平衡請求數 = (GPU 時薪 × 24) ÷ (每次請求 token 數 × 單價)
注意分母裡的「每次請求 token 數」。這正是微調帶來的第二個效益。
Day 19 談過 System Prompt 是一項永久成本 —— 每一次請求都要重付。而微調把規則內化進權重之後,配置 C 只需要三句話,而不是完整規則加上 few-shot。
昨天的對決已經量出了這個差距(Day 23 的 Token 成本對照表)。它的效果是同時降低分母,把損益平衡點往左推。
換句話說:微調不只讓模型變準,也讓自架這個選項更早划算。
用一組假設值走一次流程:
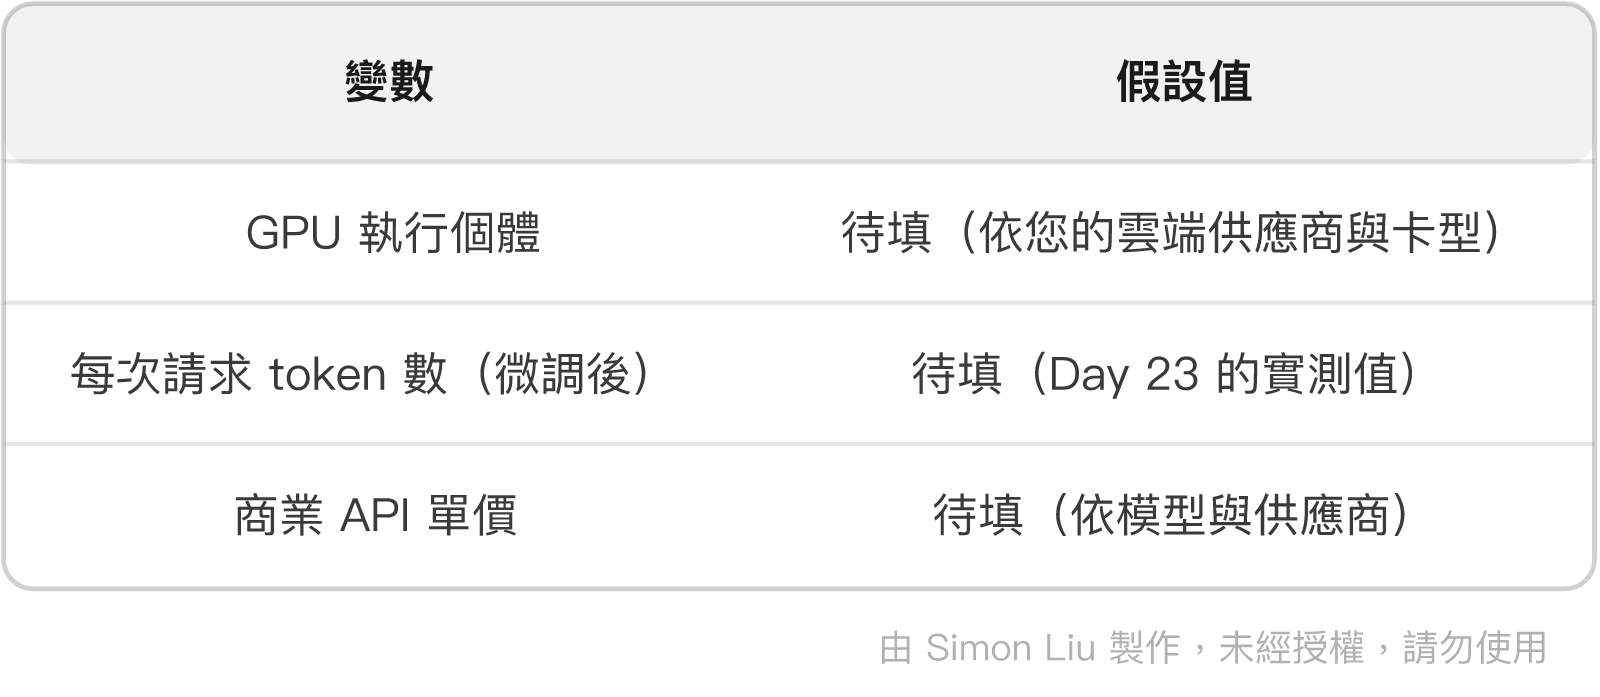
這三個數字必須用您自己的實際條件填。 雲端價格、模型單價與請求規模因團隊而異,抄別人的試算表得到的結論不會成立。這裡提供的是計算方法,不是結論。
試算表最容易失真的地方,是只算了顯而易見的部分。
第一,GPU 的閒置時間。 商業 API 沒有請求就不收費,自架的卡二十四小時都在燒錢。如果流量集中在上班時間,實際的有效使用率可能只有三分之一。
第二,維運人力。 模型更新、服務重啟、監控告警、版本管理 —— 這些都是持續的投入。商業 API 把這部分外包掉了。
第三,重訓成本。 工具改版、業務規則變更、基座模型更新,都可能需要重新訓練一輪。這不是一次性成本,而是週期性的。
把這三項加進去之後,損益平衡點通常會往右移不少。 誠實地把它們算進去,比得出一個漂亮但站不住的結論有價值。
不過成本並不是唯一的判準。有三個因素在某些場景下的權重,遠高於帳面數字。
第一,資料隱私與合規。 差勤資料經常包含內部主機名稱、帳號、拓撲結構。有些產業的規範直接禁止這些資料離開自有網路 —— 這種情況下自架不是選項之一,而是唯一選項。
第二,延遲的可控性。 自架的延遲取決於自己的硬體,而商業 API 的延遲取決於對方的負載。對於需要穩定回應時間的場景,可預測性本身就是價值。
第三,版本的穩定性。 商業 API 的模型會更新,而更新可能改變行為 —— 昨天調好的 Prompt 今天可能失效。自架的模型權重是凍結的,它昨天怎麼做,今天就怎麼做。
這一點對本系列特別有意義:Day 13 凍結的那把尺之所以能用到 Day 23,前提就是受測對象的行為是可重現的。
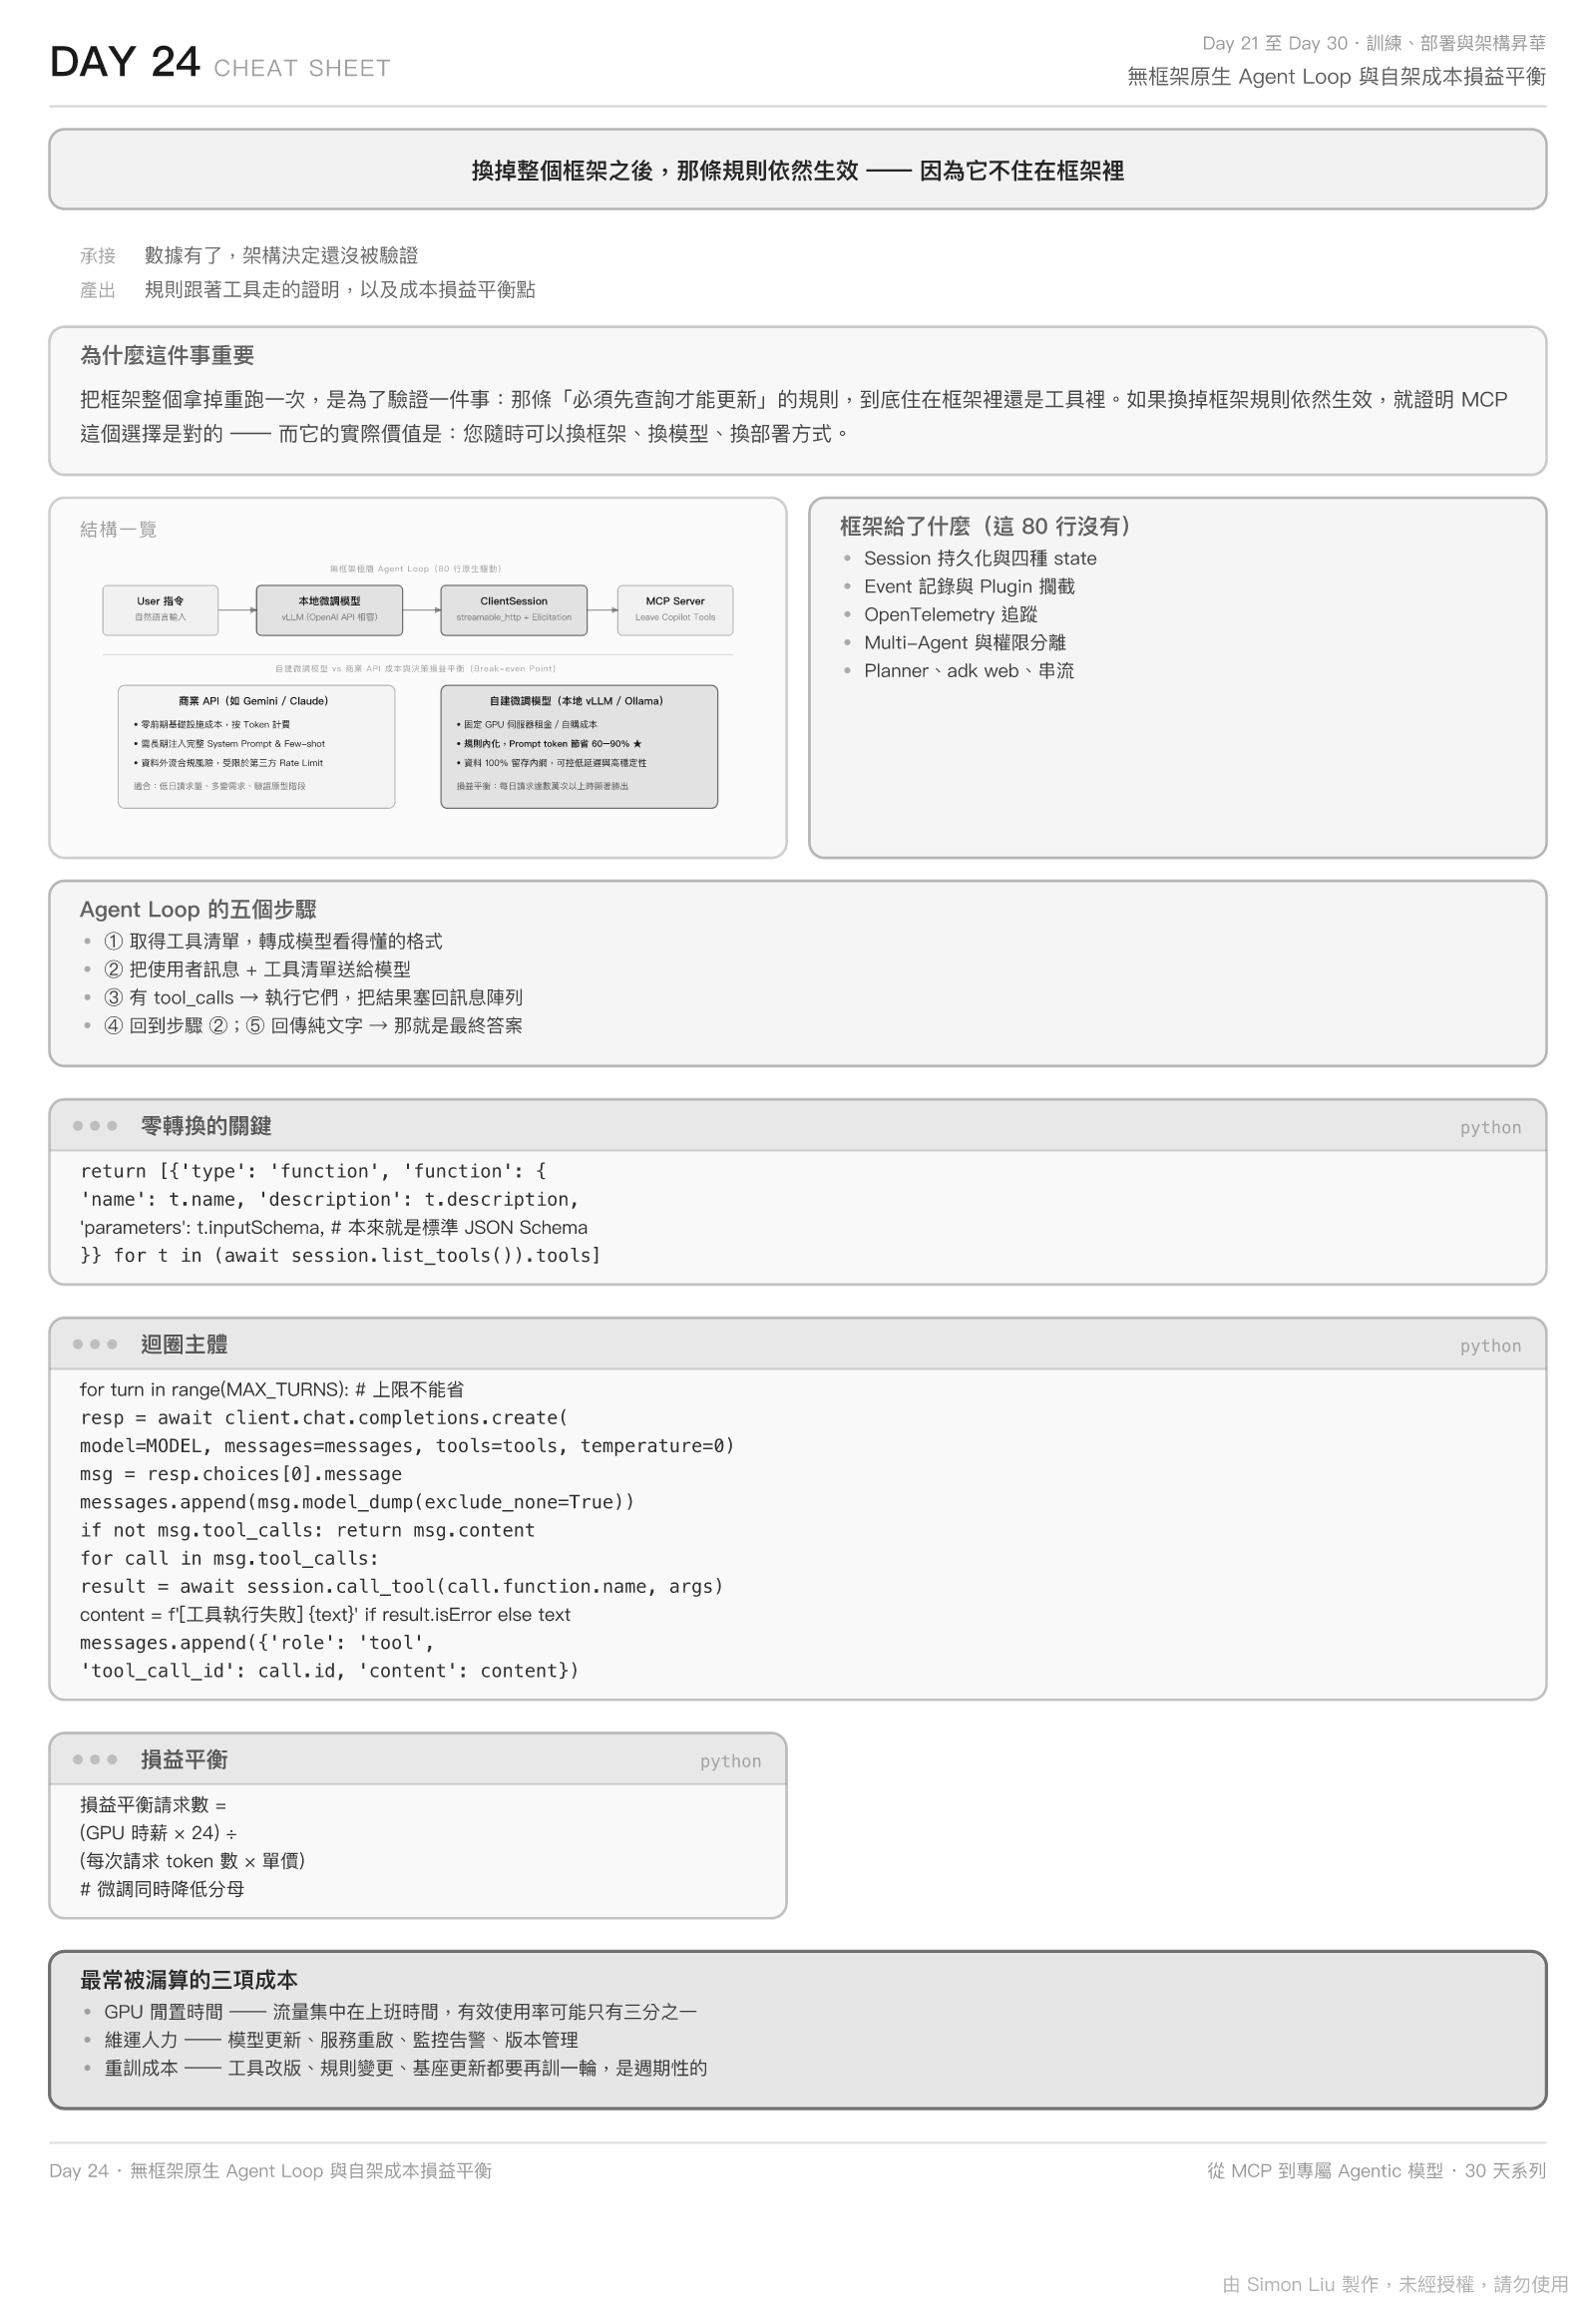
今天做了兩件事:把框架拆掉驗證架構決定,以及把成本算清楚。
總結來說,今天有三個重點值得帶走:
到這裡為止,這 24 天的閉環已經完整走完一遍了。接下來的六天要往外擴 —— 從單一系統的實作,走到架構層面的思考。明天先處理一個最根本的選型問題:什麼時候該用工作流,什麼時候才真的需要自主 Agent?
ClientSession、call_tool、CallToolResult.isError
inputSchema 為 JSON Schematools 與 tool_calls 的訊息結構查證日期:2026-08-24
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術